4IIS
1.
概述:美国CN2机房与运维关注点
- CN2多指中国电信CN2骨干线路,部分美国机房宣称与CN2直连以优化回国链路。
- 运维关注点包括链路稳定性、跨洋时延、丢包率和BGP路由策略。
- 典型影响面:VPS连通性、域名解析路径、CDN回源和DDoS防护效果。
- 衡量指标:RTT(ms)、丢包(%)、带宽利用率(%)与可用性(%)。
- 运维目标:将关键业务可用性控制在SLA目标之上,同时保证MTTR在可接受范围内。
2.
网络故障检测与告警机制
- 被动监控:流量镜像与NetFlow/sFlow用于检测异常流量与DDoS特征。
- 主动监控:定时ping/traceroute到目标POPs及回国骨干节点,采样周期建议10s-60s。
- BGP监控:监测Prefix变化、AS路径和社区标记,异常变更触发高级告警。
- 阈值设置:RTT>200ms或丢包>1%连续5次触发二次确认告警。
- 告警路由:SRE值班→网络工程师→上游运营商support,形成可追踪的工单链路。
3.
故障处理流程与SLA承诺细则
- 分级响应:Critical(影响大部分用户)/Major/Minor,不同级别MTTR目标不同。
- 常见SLA承诺:99.95%月可用率(等效允许停机≈21.6分钟/月);99.99%≈4.3分钟/月。
- SLA赔付示例:可用性低于承诺,每下降0.1%按月账单比例返还或抵扣(具体以合同为准)。
- 工单流程:检测→定位(链路/机房/宿主机/虚拟化层)→临时缓解→根因分析→修复与验证。
- 指标记录:每次故障需保留RTT、丢包、BGP日志与tcpdump抓包作为证据用于SLA申诉。
4.
真实案例:US-CN2链路突发丢包的处置(匿名化)
- 事件概要:2024-09-12 02:10 UTC,客户报告回国链路丢包率突增至15%,影响Web访问。
- 初步监测:NMS显示从美西POPs到中国方向多点丢包,traceroute在第三跳出现AS路径振荡。
- 定位过程:抓包与BGP路由历史回溯显示某上游向社区标记误配导致流量Blackhole策略触发。
- 处置步骤:临时BGP撤回受影响前缀并优先使用备用CN2承载,上游工程师修正社区后逐步恢复。
- 时序与结果:检测02:10→定位02:25→缓解02:40→完全恢复03:05;总影响约55分钟,按SLA申请了部分赔付。
5.
服务器配置示例与容灾对比(含表格)
- 示例配置1:面向前端的小型实例用于快速伸缩与边缘缓存。
- 示例配置2:后端数据库与状态服务需要更高IO与内存保障。
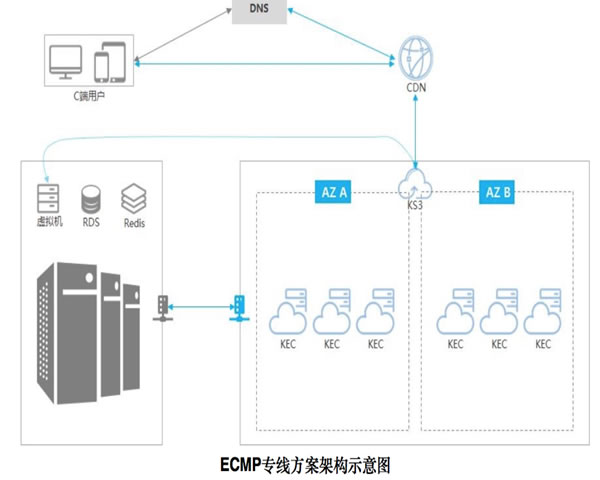
- 负载均衡与CDN:在US端部署GSLB与多点回源以减少单点故障风险。
- DDoS防护:结合云端清洗+机房ACL与黑洞策略分层防御,快速响应SYN/UDP泛洪。
- 容灾策略:多可用区+跨机房主动路由切换与定期演练。
| 类型 | 配置 | 用途 |
|---|---|---|
| 前端VPS | 4 vCPU / 8 GB / 1 Gbps | Web缓存、CDN回源 |
| 后端主机 | 12 vCPU / 64 GB / NVMe 1TB | 数据库、写密集型服务 |
| 坐席/跳板 | 2 vCPU / 4 GB / 专属带宽100Mbps | 远程维护通道 |
6.
运维建议与优化实践
- 制定并验证SLA条款:明确可用性口径、数据采集方式与赔付规则。
- 建立跑单与演练:定期演练BGP切换、CDN回源Failover与DDoS清洗流程。
- 多层监控:融合业务、主机、网络与上游链路的数据,避免单点视角误判。
- 容量与阈值管理:基于95/99百分位流量预留带宽,设置弹性伸缩策略。
- 日志与证据保存:故障发生后至少保留30天的pcap、BGP更新和监控快照便于SLA申诉。